FusionCore
多精度计算 IP,将矩阵、向量与特殊函数通路、片上存储和数据搬运组织为可组合模块。面向端侧 LLM,支持低位宽格式、块缩放和按需精度回退。
DATAFLOW-DRIVEN GPNPU
端侧推理的瓶颈不只是峰值算力。权重容量、有效带宽、非矩阵算子以及模型持续演进,要求计算、数据搬运和编译调度共同设计。
多精度计算 IP,将矩阵、向量与特殊函数通路、片上存储和数据搬运组织为可组合模块。面向端侧 LLM,支持低位宽格式、块缩放和按需精度回退。
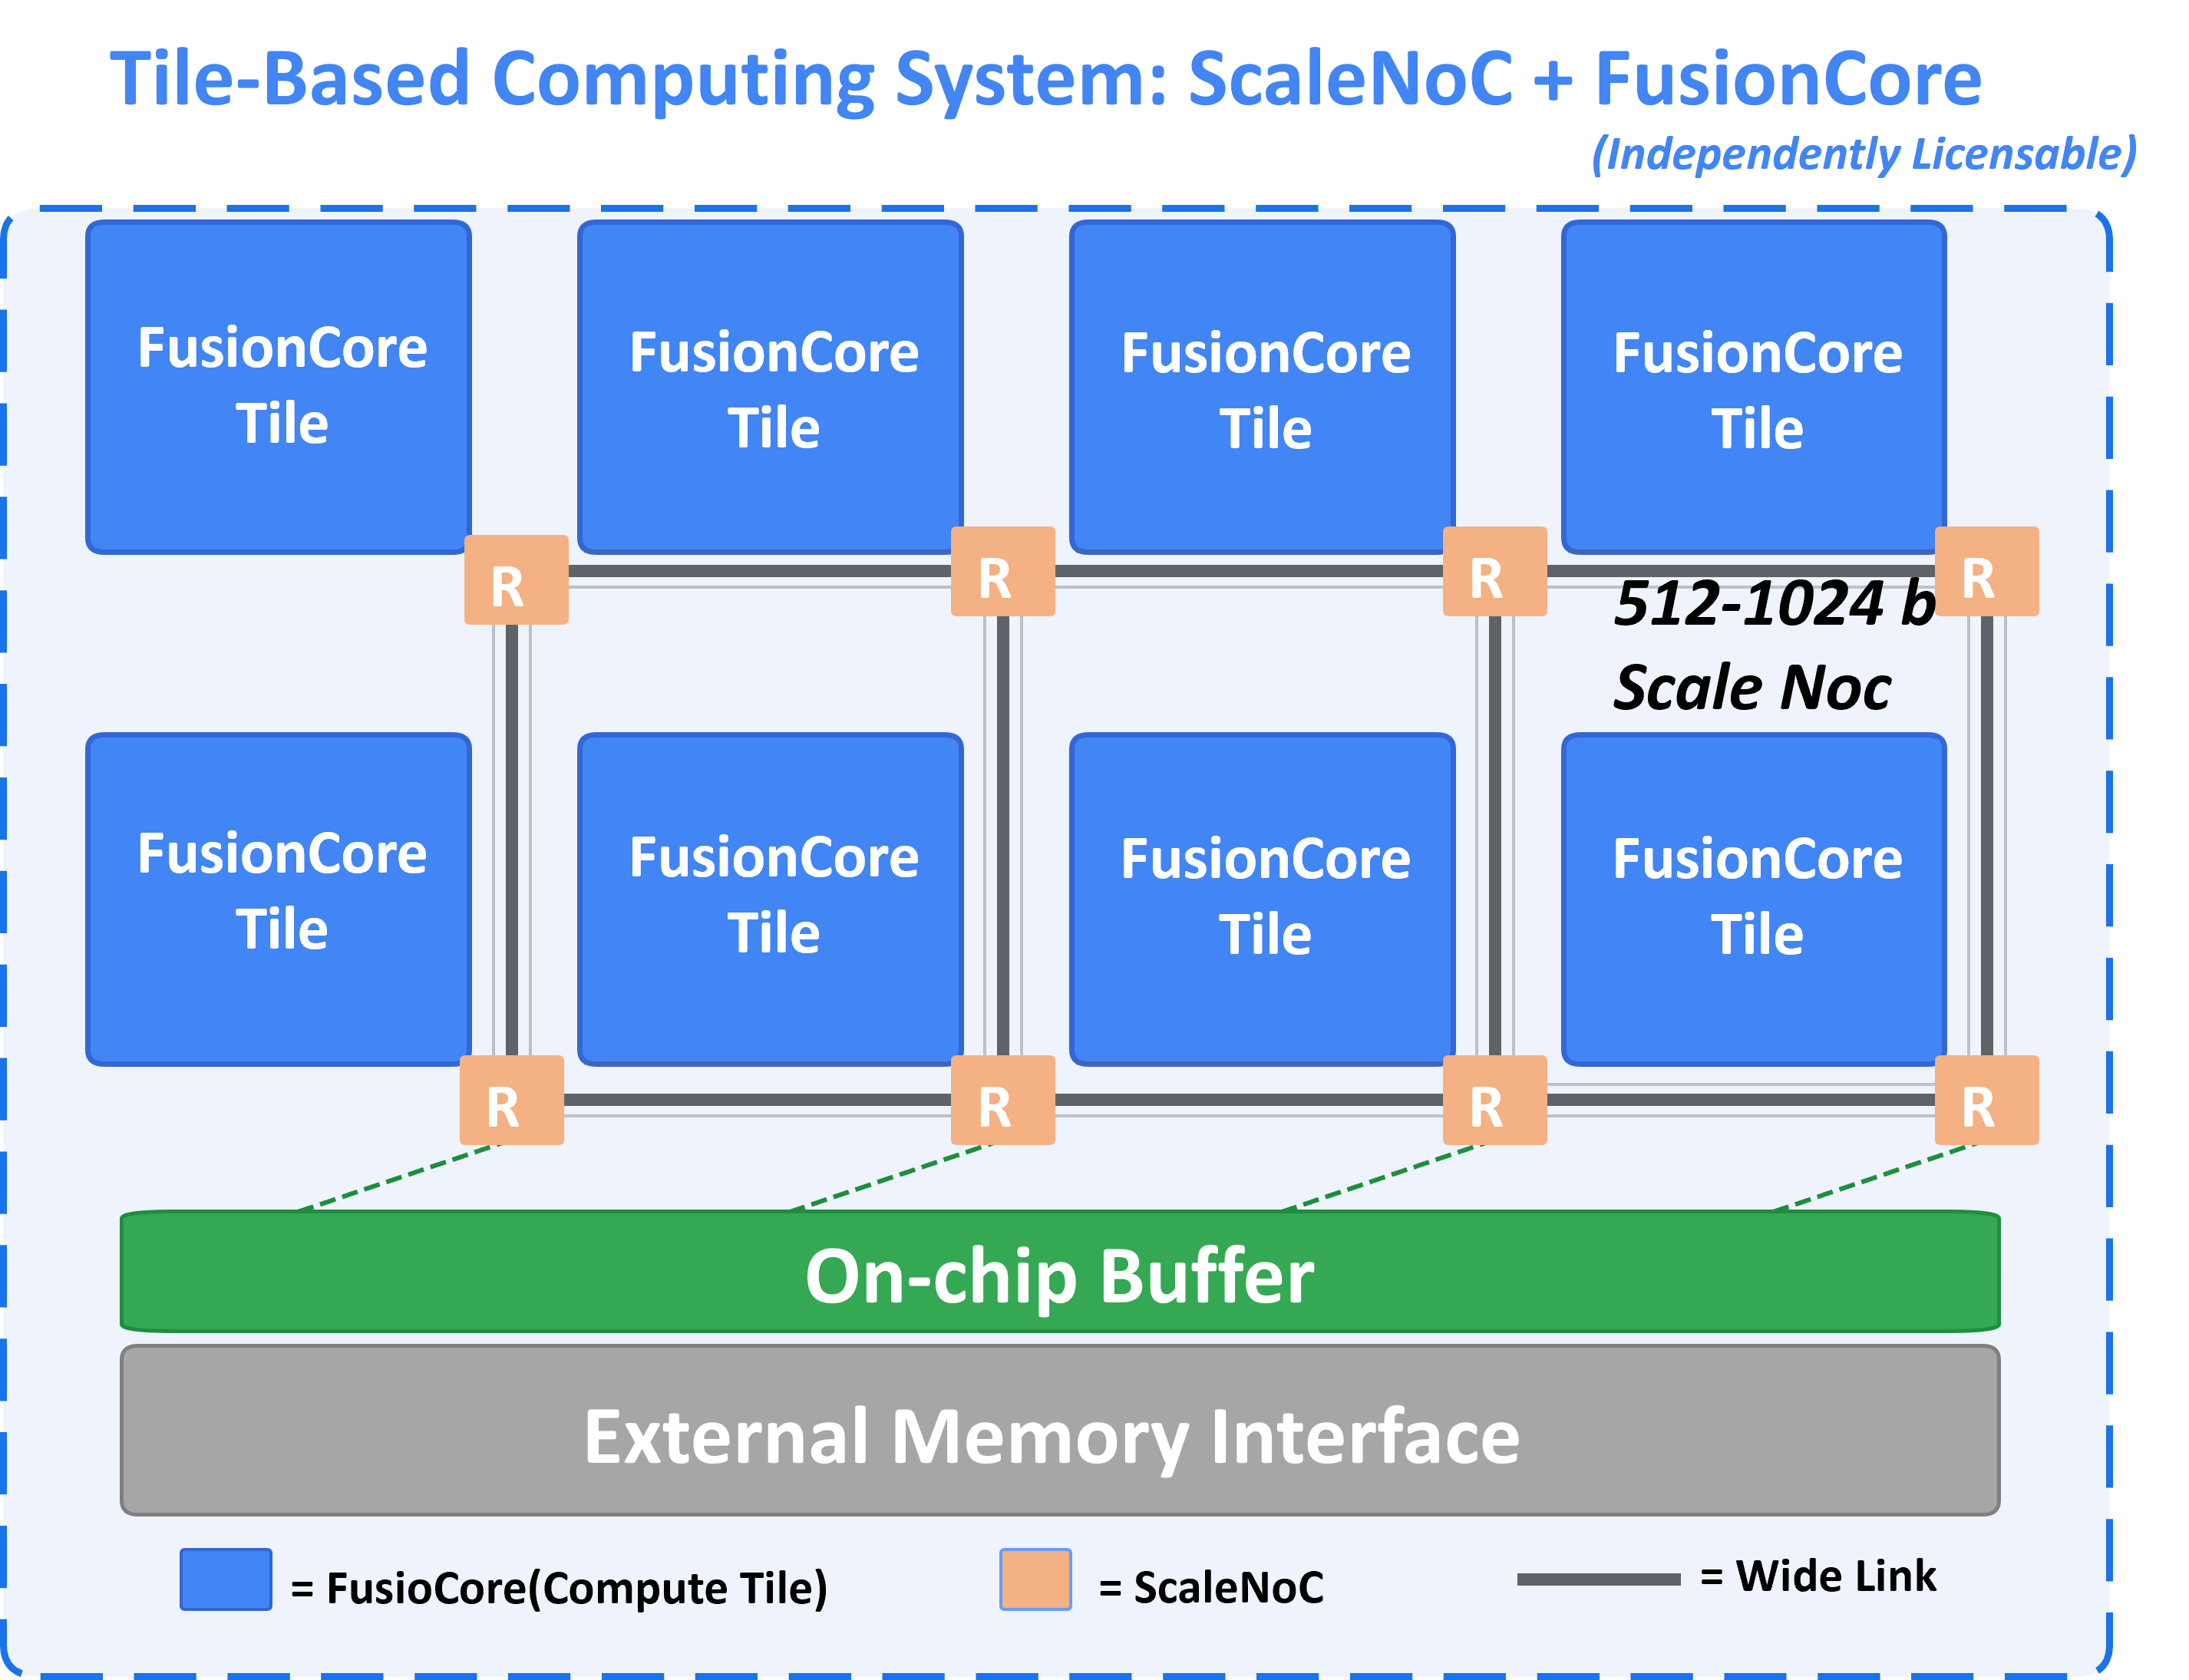
面向多计算核心、片上存储和内存接口的数据流互连。拓扑、链路和带宽可按客户芯片配置,并对稀疏计算和 MoE 的专家权重搬运优化。
编译、调度与运行时,结合算子形状和片上资源安排分块、布局、搬运与同步,通过算子融合和计算-搬运重叠提升有效带宽利用率。
ARCHITECTURE
计算格式、片上互连和软件调度围绕同一个模型联合优化,这也是可以分别授权、组合交付的三项核心资产。
多精度矩阵与向量计算、低位宽权重格式和片上缓冲协同。
用可配置数据流组织计算、存储与外部接口之间的数据搬运。
连接模型、算子和硬件执行,降低部署和迁移成本。
MODEL SUPPORT
同一套架构可以承接不同的激活模式和模型结构,面向真实端侧负载进行配置。
通过多精度计算和可编排数据流控制容量与访存开销。
按激活专家组织计算与权重访问,降低单 token 的活跃权重流量。
面向多模型并发场景,支持同一设备组合多个推理任务。
VALIDATION
当前工程状态以公司确认的正式版本为准;具体性能、功耗和接口信息将在样片与系统测试后发布。
核心计算模块完成工程级开发,并持续开展验证。
Qwen-8B 已在 FPGA 原型完成端到端验证。
首代产品推进系统集成、后端和流片准备。
通过样片测试和客户工作负载评估产品能力。
SYSTEM VIEW
外部主机继续运行操作系统和应用;片内管理 CPU 负责任务调度,计算 Tile 完成矩阵、向量和数据搬运。
NEXT
VLX-64 提供 M.2 与 USB 工程模组形态,后续 VLX-512 面向更大容量和工作站/边缘场景。