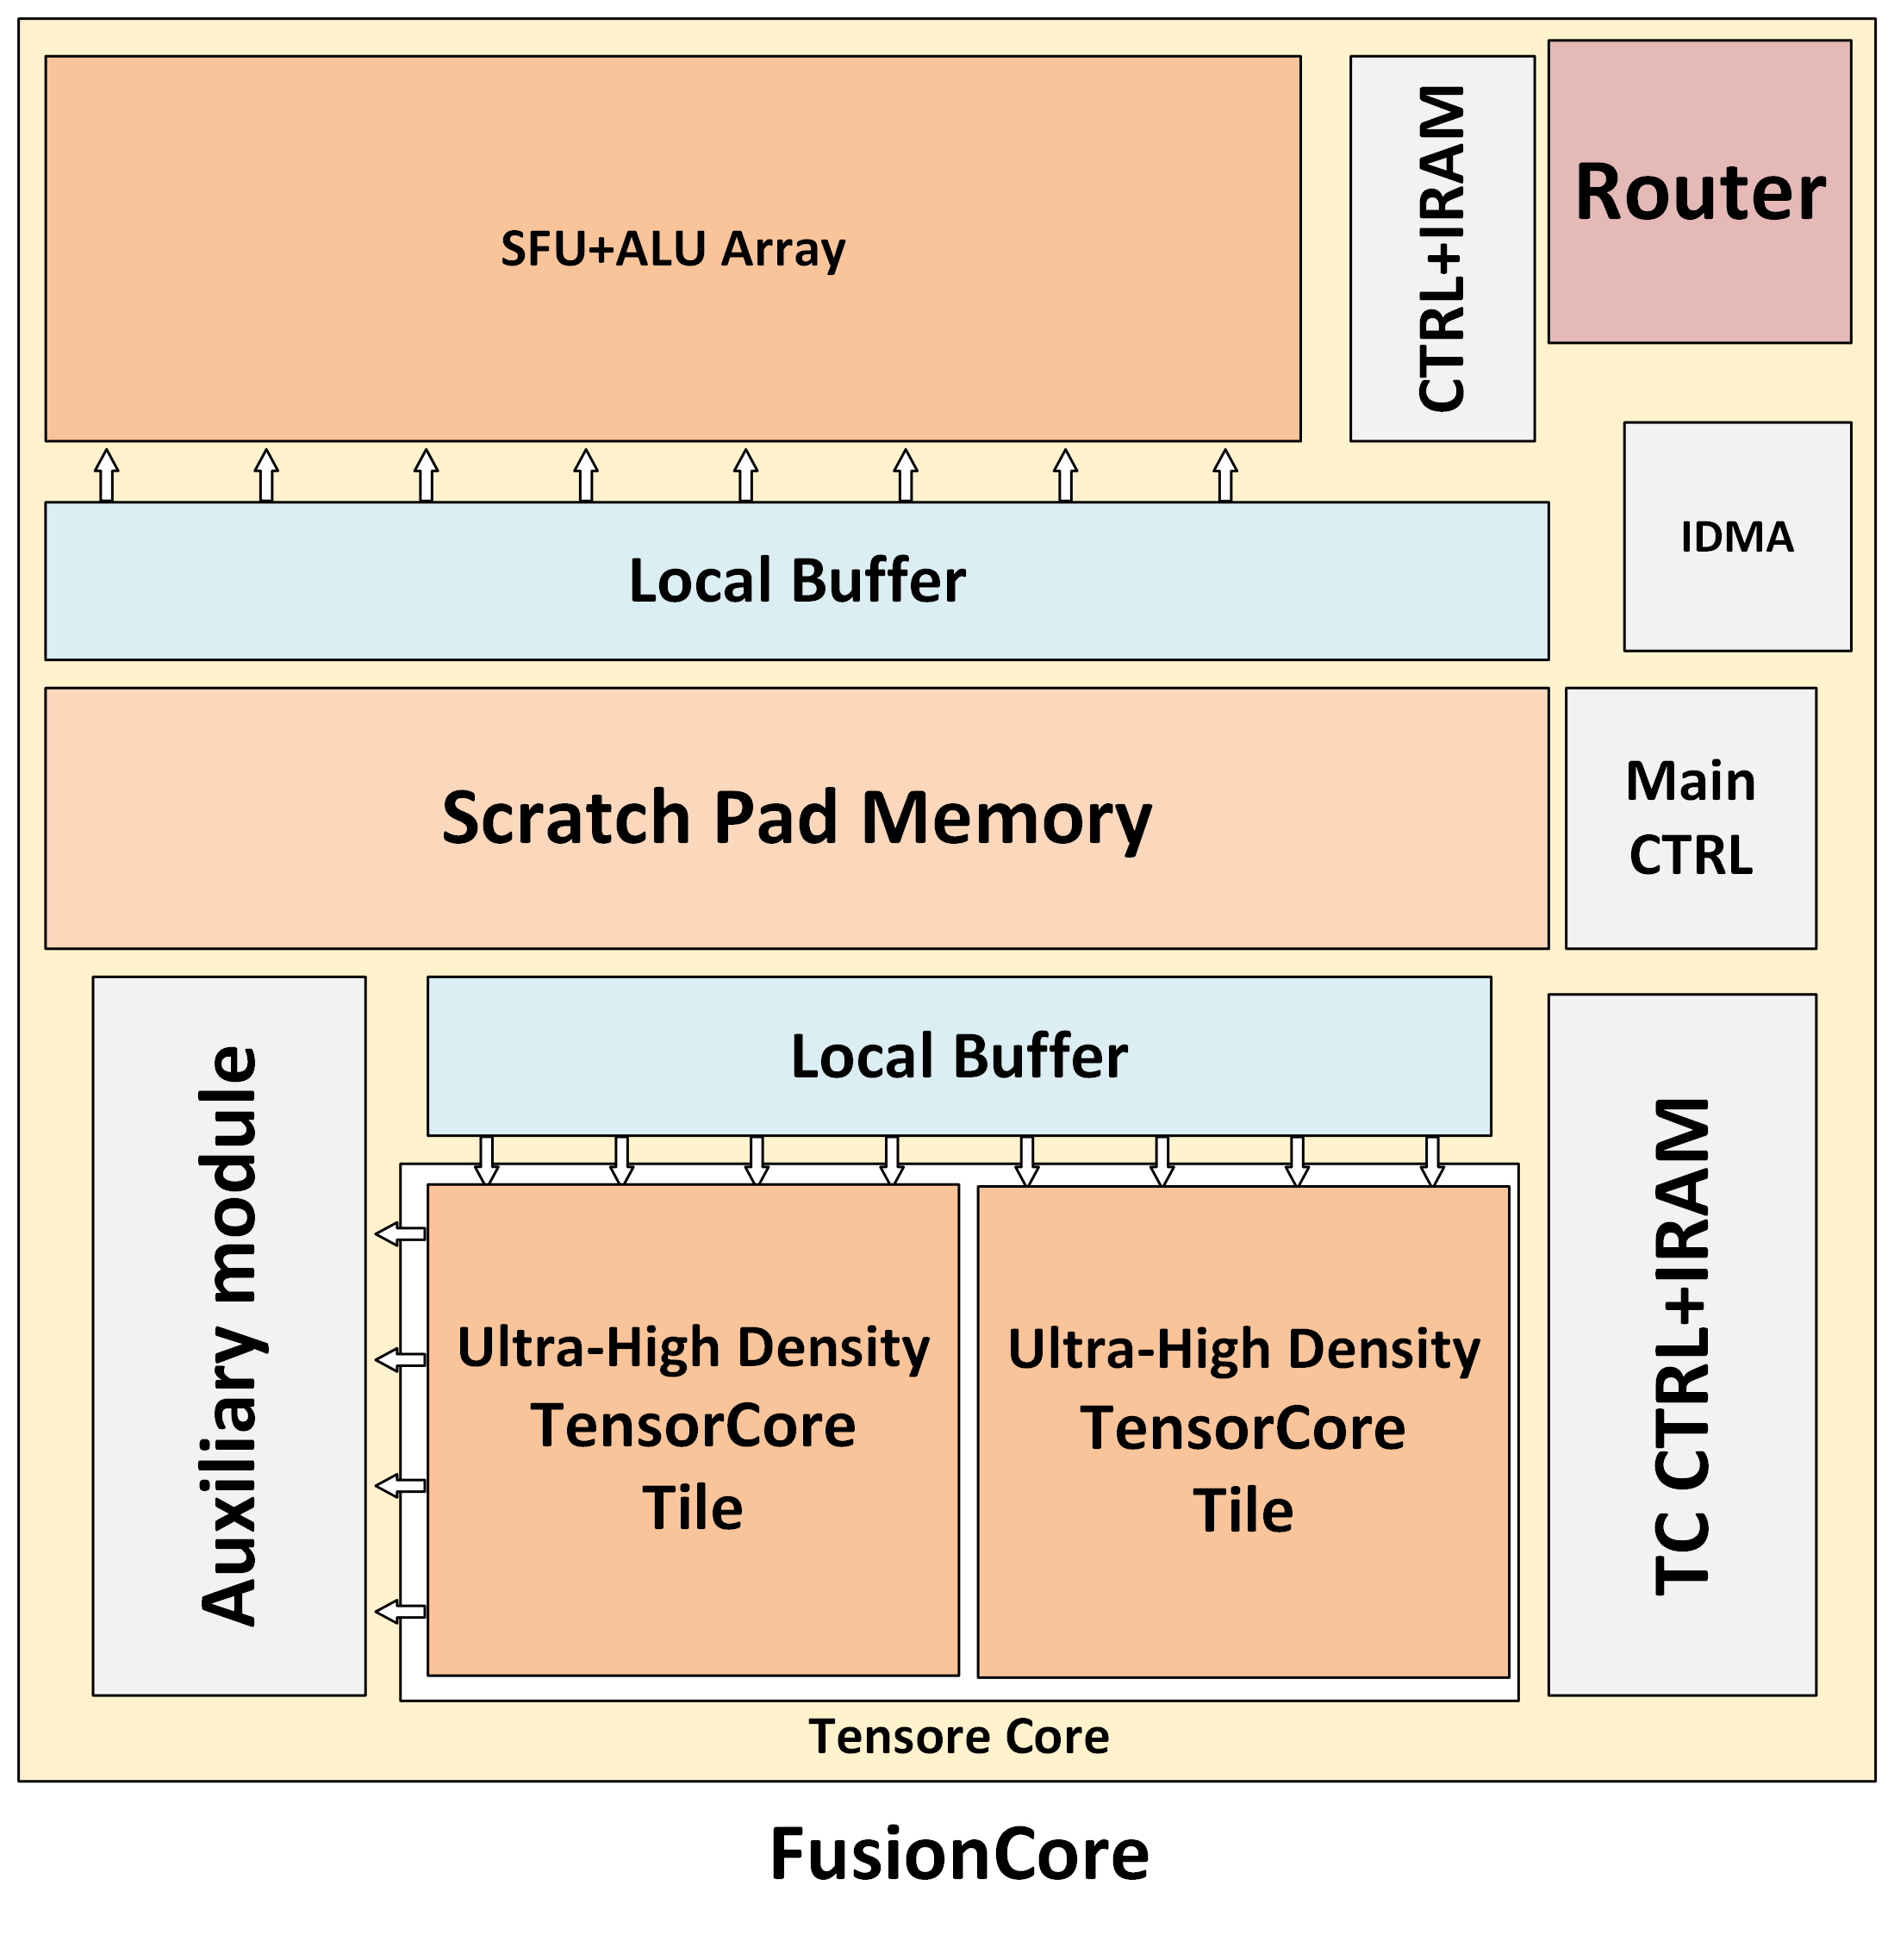
FusionCore 计算 IP
面向大模型推理的计算核心,结合矩阵计算、向量处理和片上存储,按任务配置精度与规模。
- 多精度计算与块缩放
- 矩阵、向量及特殊函数通路
- 可作为计算 IP 或计算子系统授权
COMPUTE + INTERCONNECT IP
面向芯片公司、SoC 与加速器团队,提供 FusionCore 计算 IP、ScaleNoC 互连 IP,以及子系统与定制设计服务。
IP PORTFOLIO
授权范围、交付版本、验收和付款安排按具体项目约定;计算规模、精度和接口可按客户系统需求配置。
面向大模型推理的计算核心,结合矩阵计算、向量处理和片上存储,按任务配置精度与规模。
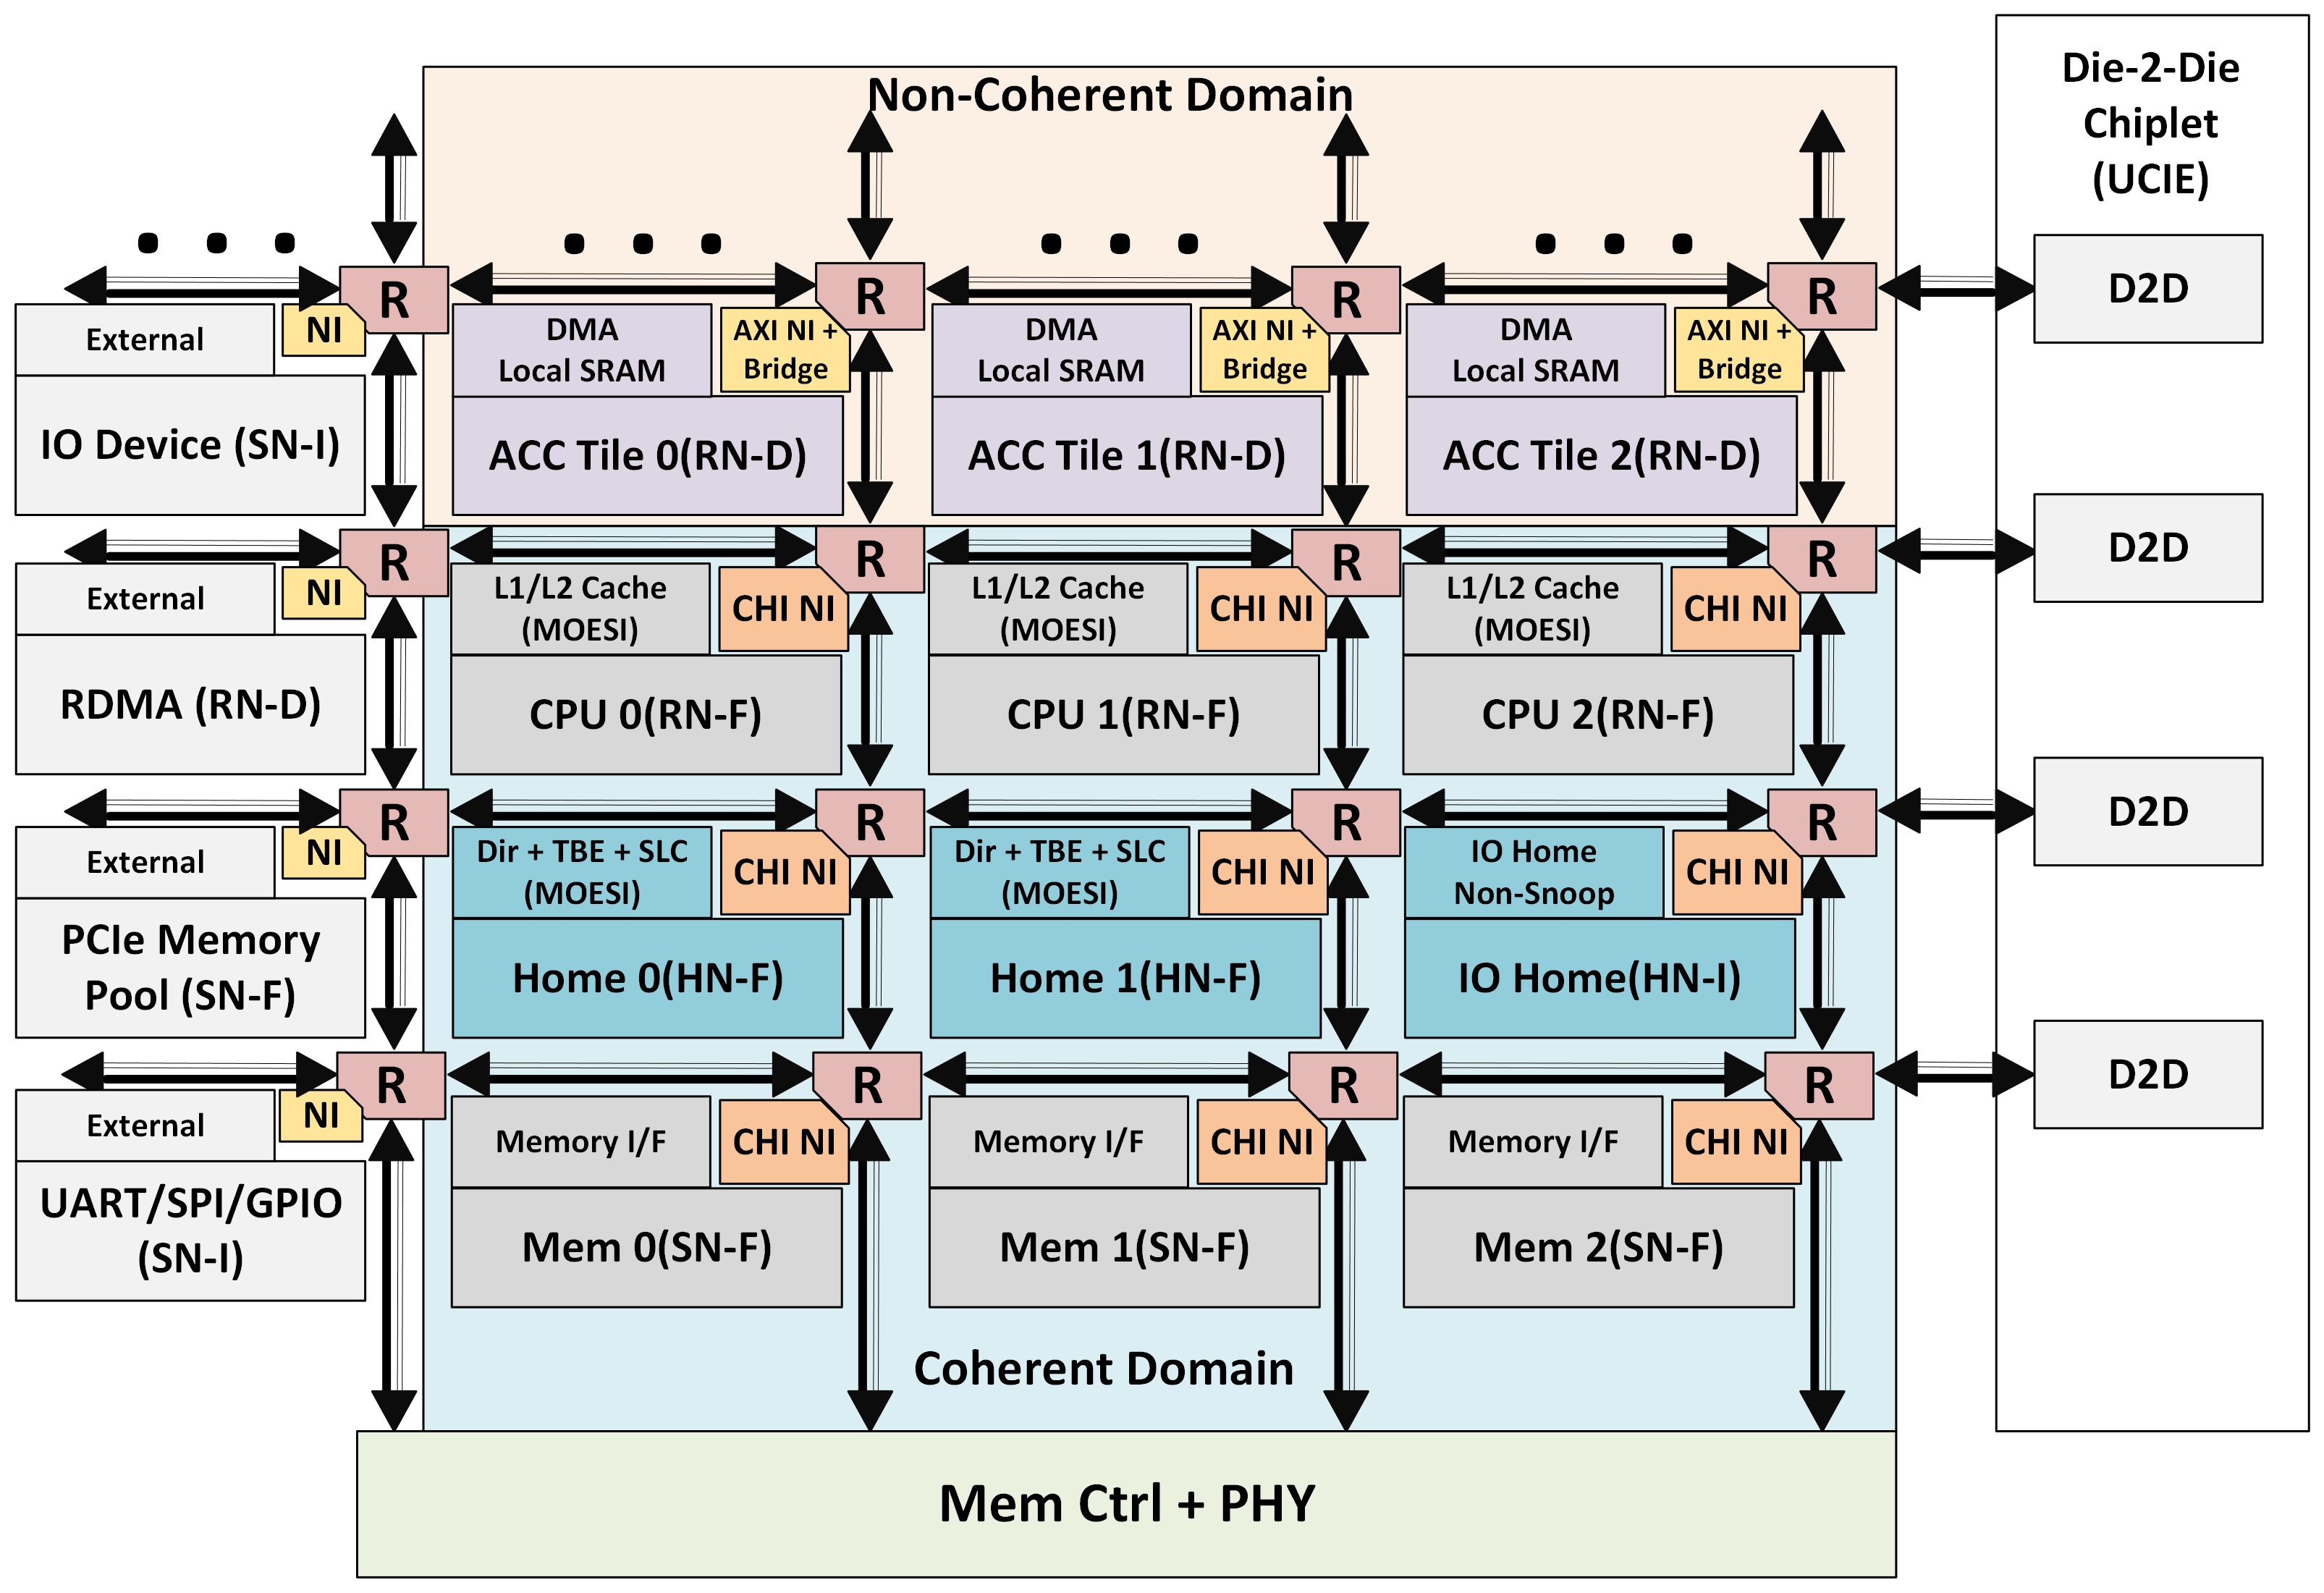
连接多个计算核心、片上存储与外部接口,按数据流配置拓扑和链路带宽。
从模型、精度、计算规模、内存系统和接口约束出发确定架构边界。
完成计算 IP、互连、软件接口和目标系统的适配与集成。
按项目约定完成验证、版本交付、验收和支持。
IP ARCHITECTURE
FusionCore 与 ScaleNoC 可作为独立模块合作,也可组合为计算子系统,按客户芯片的模型、精度、接口和系统规模配置。
FROM IP TO PRODUCT
芯片项目积累的可复用模块、软件和验证经验,进一步用于 VLX 系列加速产品。